Acceso
 Ayuda
 Obtener Verificación
EN ESTA PÁGINA
- El problema del fraude documental ha cambiado de forma
- Por qué los documentos no estructurados importan en la debida diligencia
- Por qué la revisión manual no es suficiente
- Cómo funciona la verificación automática de documentos no estructurados
- Lo que sucede cuando se marca un documento
- Donde el criterio humano sigue importando
- La conclusión
noviembre 5, 2026

Entrada de blog
La importancia de la verificación de documentos no estructurados: el riesgo de fraude oculto
Un estafador ya no necesita conocimientos de Photoshop para engañar a tu equipo de cumplimiento. Solo necesita un prompt.
La IA generativa puede crear extractos bancarios convincentes en segundos, lo que hace más difícil detectar los indicadores de fraude tradicionales. A medida que la manipulación de documentos se vuelve más fácil, verificar la evidencia es tan importante como verificar a la persona que está detrás.
Ahí es donde entra en juego la verificación de documentos no estructurados.
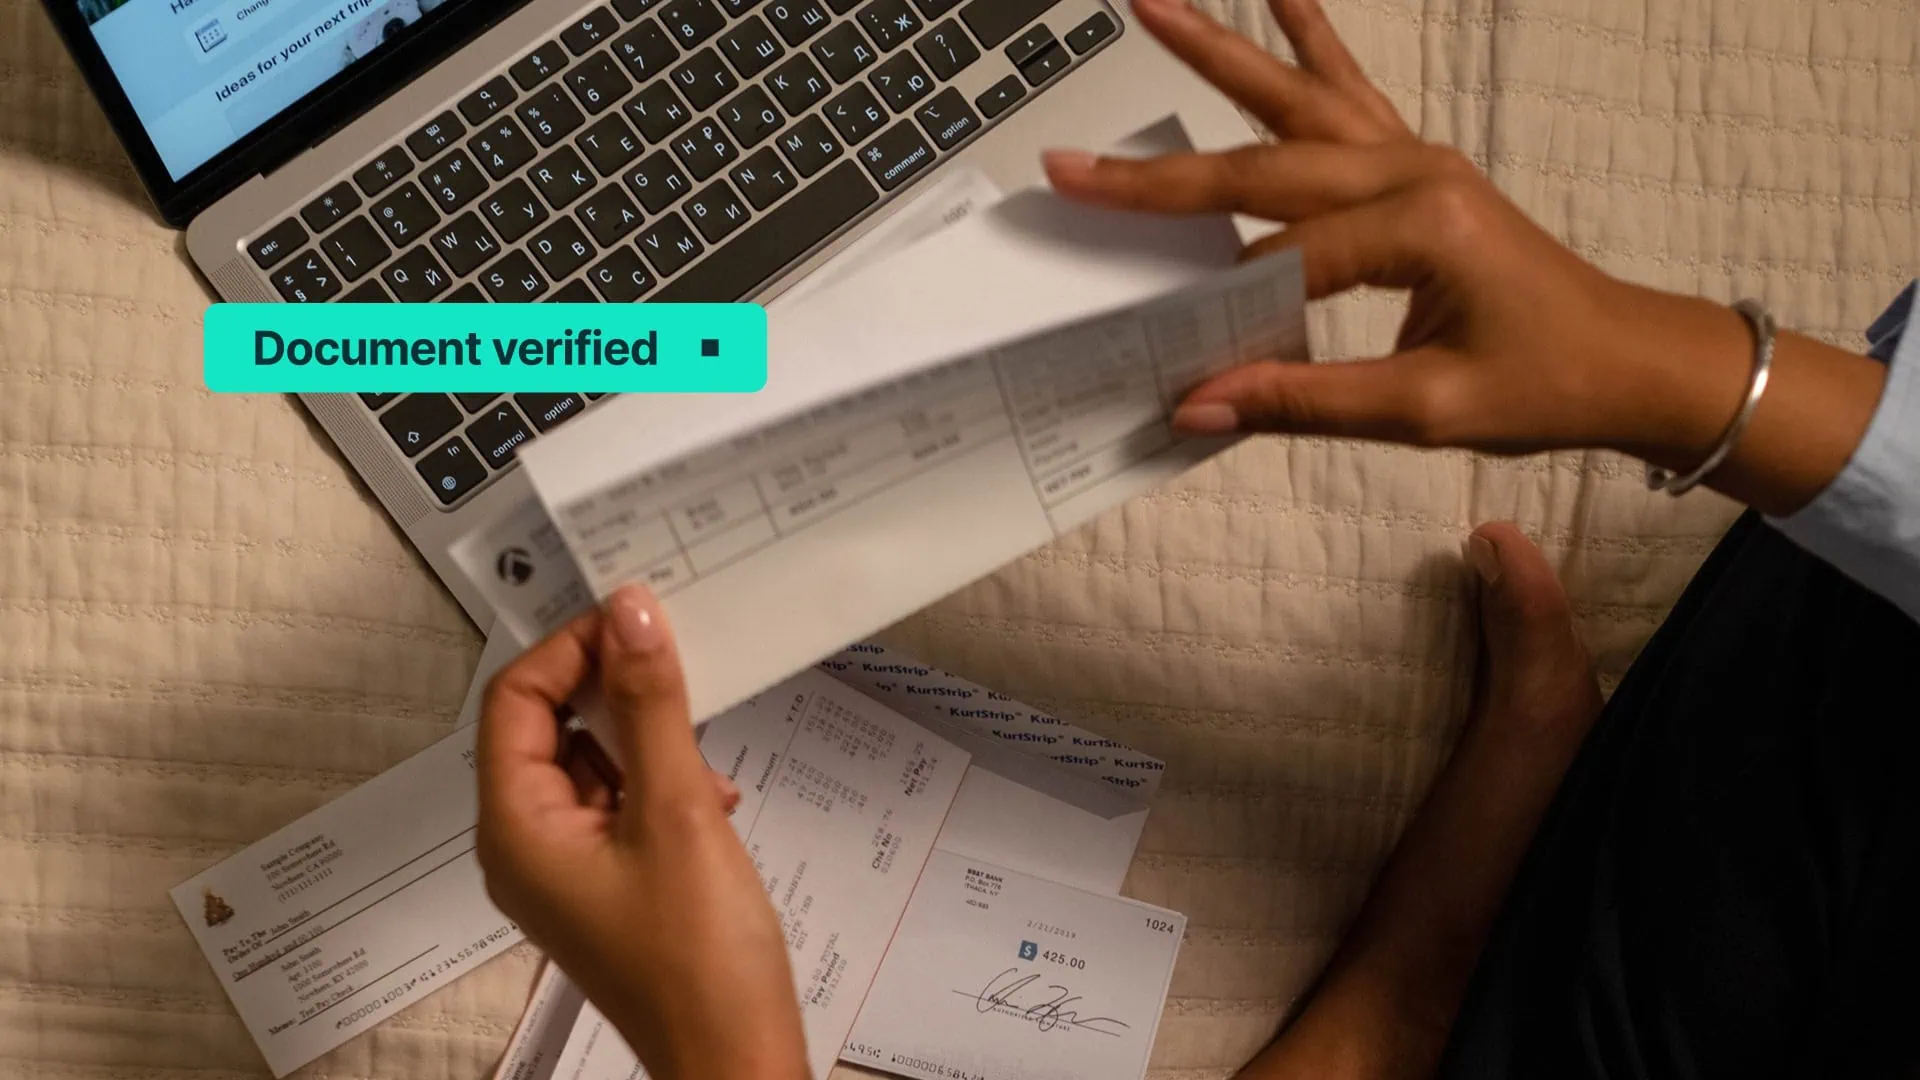
Un estafador ya no necesita tener conocimientos de Photoshop para pasar la revisión de tu equipo de cumplimiento. Solo necesita un prompt.
Pídele a tu herramienta de AI favorita que genere un extracto bancario. En segundos, tendrás un documento completo con el logo del emisor correcto, el formato adecuado e historiales de transacciones que parecen totalmente reales. Sin errores de tipeo. Sin fuentes desalineadas. Sin las señales de alerta que un revisor humano está entrenado para detectar. Los errores tontos que antes delataban el fraude, como un logo estirado, una fuente inconsistente o un saldo sospechosamente redondo, están desapareciendo. Los modelos de AI se han vuelto demasiado buenos.
Este cambio ha revelado un punto ciego en la verificación de identidad. La industria ha pasado años reforzando la manera de verificar la identidad de las personas, pero la verificación de las pruebas que presentan, como extractos bancarios, facturas de servicios públicos o contratos firmados, se ha quedado atrás. Esa brecha es ahora la puerta de entrada más fácil para el fraude, y la verificación de documentos no estructurados se creó para cerrarla.
El problema del fraude documental ha cambiado de forma
Durante la mayor parte de la última década, el fraude de identidad se centraba en los documentos de identidad, como pasaportes falsificados, licencias de conducir manipuladas o fotos impresas sostenidas frente a una cámara. Esa amenaza no ha desaparecido, pero ahora es más difícil de llevar a cabo con éxito porque los documentos de identidad plásticos están estandarizados. Los gobiernos e instituciones que los emiten mantienen muestras conocidas. Los códigos de barras se pueden comparar con los datos impresos. Cada campo tiene un formato esperado y las desviaciones son detectables porque existe una fuente de verdad para comparar.
Los documentos no estructurados no tienen esa fuente de verdad.
Un extracto bancario, un contrato de arrendamiento, una carta de prueba de domicilio. Estos documentos provienen de miles de emisores diferentes, cada uno con su propio diseño, marca y formato. Un país puede emitir una identificación nacional estandarizada, pero ese mismo país podría tener miles de formatos de facturas de servicios públicos distintos entre los proveedores regionales. No hay una muestra para cotejar, ni un código de barras para validar, ni una plantilla universal que sirva como modelo. Esa variabilidad, que antes hacía que procesar estos documentos fuera simplemente un inconveniente, ahora los convierte en el camino más fácil para el fraude.
Y el fraude no se limita a cambiar un nombre o una dirección. El fraude en los extractos bancarios ocurre cada vez más a nivel de las transacciones, con depósitos falsos, saldos alterados y registros insertados o eliminados para presentar una imagen financiera completamente diferente. El documento sigue pareciendo un extracto bancario. Sigue teniendo el logo correcto. Simplemente no es real.
Por qué los documentos no estructurados importan en la debida diligencia
A medida que los requisitos de debida diligencia se vuelven más estrictos en las industrias reguladas, la verificación de identidad por sí sola ya no es suficiente. Incluso cuando una identificación incluye una dirección, ese único documento a menudo no puede soportar el peso de una verificación completa de la identidad y la dirección por sí mismo, razón por la cual muchas empresas de tecnología financiera requieren un segundo documento para confirmar la residencia. Otros casos de uso siguen impulsando el requisito: verificar la titularidad de una cuenta bancaria, confirmar el origen de los fondos, validar los datos fiscales con un SSN o establecer la identidad en países donde no existen identificaciones estandarizadas o no se pueden procesar en un formato utilizable.
Los documentos de respaldo, como extractos bancarios, facturas de servicios públicos y recibos de pago, han pasado de ser un caso aislado a una expectativa en muchos flujos de verificación. Las empresas reguladas necesitan una forma de procesar y validar estos documentos, y ese es el vacío que la verificación de documentos no estructurados está diseñada para llenar.
Por qué la revisión manual no es suficiente
La revisión humana nunca fue suficiente para este problema a gran escala. Tres debilidades estructurales lo dejan claro:
Cobertura lingüística. Las empresas globales no pueden contratar revisores para cada dialecto y formato de documento regional que los usuarios puedan presentar. Un país como la India, con su variedad de dialectos y documentos, ilustra bien este problema: la mayoría de las empresas no pueden tener una cobertura interna completa, sin siquiera considerar el control de calidad necesario para verificar el trabajo de los propios revisores.
Experiencia en fraude. Para detectar un extracto bancario manipulado, hay que saber exactamente qué buscar. Ese conocimiento especializado es difícil de enseñar, más difícil de escalar y se desactualiza constantemente. Lo que hoy es una señal clara de fraude, mañana puede ser un problema resuelto para los estafadores, ya que las técnicas de fraude evolucionan a la par de las de detección. Mantener el conocimiento de un equipo humano actualizado, coherente y bien distribuido entre los revisores es una carga operativa continua y sin un límite claro.
Velocidad. Incluso dejando de lado el fraude, una revisión manual de la integridad y el tipo de un documento puede llevarle a un revisor humano entre 50 segundos y varios minutos, según su complejidad. Un contrato que verifica la propiedad de un inmueble o un vehículo requiere leer todo el documento para encontrar e interpretar los detalles relevantes. Esto representa una demora significativa en el proceso del usuario, donde la conversión depende de decisiones instantáneas.
Nada de esto significa que la revisión manual no tenga su lugar. Significa que la revisión manual por sí sola ya no puede soportar la carga que exige el panorama de amenazas actual.

El fraude de identidad sintética es diferente: se construye con datos que nunca se reportan como robados, por lo que nunca se cancelan. La IA generativa cierra la brecha final al producir documentos convincentes que los respaldan.
Cómo funciona la verificación automática de documentos no estructurados
Para solucionar este problema es necesario analizar un documento como lo haría un especialista, pero más rápido y a una escala que ningún equipo podría mantener. Esto significa operar simultáneamente en tres capas distintas:
Estructura del documento. ¿Una factura realmente parece una factura? Esta capa comprueba la presencia y la disposición de los elementos que un tipo de documento determinado debería tener: un emisor, un destinatario y detalles pertinentes, como el consumo de electricidad o gas en una factura de servicios. Es el primer filtro para saber si un archivo enviado coincide con lo que dice ser.
Metadatos. Todo archivo digital deja una huella: un historial de edición, propiedades del archivo y otros indicadores digitales que pueden revelar si un documento ha sido alterado, incluso cuando su aspecto visual parece impecable.
Estructura visual. Esta capa examina el documento a nivel de píxel: fuentes inconsistentes, irregularidades de formato y contexto de fondo que puedan indicar la práctica de «document farming», es decir, la generación repetitiva de documentos fraudulentos casi idénticos. Estas son las señales que al ojo humano le cuesta cada vez más detectar, pero que un modelo entrenado específicamente para buscarlas puede identificar.
La clasificación y la extracción complementan estas verificaciones. Primero, la clasificación identifica el tipo de documento y su emisor. Luego, la extracción lee la información y extrae los datos necesarios para la verificación, como cifras de ingresos o fechas de emisión. Después, la comprobación de alteraciones añade una capa extra de seguridad, ya que un documento clasificado correctamente aún puede ser fraudulento. Todo esto toma solo segundos. Un sistema automatizado puede escanear y clasificar un documento en menos de 10 segundos, mientras que una revisión manual tarda desde 50 segundos hasta varios minutos. Si un tipo de documento no es compatible, el sistema te lo informa al instante y te sugiere alternativas aceptadas. Así, el proceso de verificación sigue avanzando.
Lo que sucede cuando se marca un documento
Cuando un documento se marca como potencialmente alterado, nunca se notifica directamente al usuario final. Esto es intencional y es importante para el cumplimiento normativo. Si se alertara a un posible estafador de que su documento fue detectado, se incumplirían las obligaciones de informar sobre actividades sospechosas (SAR). Además, le daría a los delincuentes la oportunidad de cambiar su estrategia.
En cambio, la empresa recibe una evaluación de riesgo, categorizada como Alta, Media o Baja, junto con los indicadores específicos que la generaron. Esto le da a los equipos de cumplimiento y riesgo el contexto completo para decidir cómo proceder, ya sea rechazando el documento de plano, solicitando documentación adicional o escalándolo a un revisor humano para una mayor investigación. Cuando los indicadores sugieren una manipulación fraudulenta, el sistema puede actuar para rechazar el documento y proteger a la empresa antes de que el fraude avance.
Donde el criterio humano sigue importando
La automatización cierra la brecha en escala y velocidad, pero no reemplaza la experiencia humana. Enfoca esa experiencia donde es más importante: los casos límite.
Un modelo podría marcar un documento como sospechoso por un patrón que en realidad es normal en cierta región. Un revisor con conocimiento local puede detectarlo de inmediato, mientras que un modelo necesitaría entrenamiento específico para llegar a la misma conclusión. Esto es aún más importante a medida que la verificación de documentos se expande al Know Your Business (KYB), donde revisar documentos empresariales implica entender el lenguaje legal de la región. Términos como «accionista principal» o «representante legal» pueden significar cosas distintas según la jurisdicción. Los modelos pueden aprender estos matices con el tiempo, pero la experiencia humana sigue siendo esencial para tomar decisiones legales y regionales que no tienen un patrón universal del que se pueda aprender.
El enfoque más eficaz no es la automatización en lugar de la revisión humana. La automatización se encarga de la escala, la velocidad y la consistencia, para que las personas puedan centrarse en los casos que de verdad las necesitan.
La conclusión
El fraude de documentos avanza más rápido que los procesos de verificación. Los estafadores de hoy usan herramientas con resultados que el ojo humano apenas distingue. Por eso, las defensas tienen que ser diferentes: estructurales, forenses y lo bastante rápidas para seguir el ritmo de las amenazas, que son cada vez mejores.
La verificación de identidad por sí sola no resuelve este problema y la revisión manual tampoco es suficiente. Las empresas que quieran destacar tratarán la verificación de documentos no estructurados con el mismo rigor que siempre han aplicado a la verificación de identidad.
Explora más sobre Unstructured Docs
Aprende cómo la verificación de empresas te ayuda a reducir el fraude, gestionar el riesgo y hacer el onboarding de empresas legítimas con confianza.